Ein Crawl mit erreichbaren URLs beweist noch nicht, dass Google deine Seiten indexiert hat. Wenn du deine Website crawlen willst, entscheide zuerst, ob du sie selbst untersuchen oder Google um einen erneuten Crawl einer einzelnen URL bitten möchtest. Für Statuscodes, robots.txt und gerenderte Inhalte brauchst du einen technischen Website-Crawler und die Prüfung auffälliger URLs. Geo-Autopilot, eine Plattform für SEO- und GEO-Content, nutzt einen Website-Crawl dagegen, um Markenstimme, Themen und Inhaltslücken zu erkennen.
Stand: Oktober 2026
Was möchtest du mit dem Website-Crawl herausfinden?
Ein Website-Crawler ruft Seitenadressen ab, folgt je nach Einstellung Links und hält fest, was er unter den gewählten Bedingungen vorfindet. Eine Einführung in diese Arbeitsweise bietet der Überblick zu Webcrawlern von IONOS. Für deine Werkzeugwahl zählt vor allem, welche Frage die Ausgabe beantworten soll.
Geht es um URLs und Inhalte deiner Website?
Vor einem SEO-Audit kannst du mit einem eigenen Crawl untersuchen, welche verlinkten Seiten erreichbar sind, wohin Weiterleitungen führen und ob Inhalte nach dem Laden im Browser erscheinen. Der Crawler liefert dafür eine Liste von URLs und Beobachtungen. Welche Prüfungen tatsächlich möglich sind, hängt vom gewählten Werkzeug und seinen Einstellungen ab.
Für eine technische Bestandsaufnahme brauchst du eine Ausgabe, die mindestens URL, Antwortstatus und Weiterleitungsziel erkennbar macht. Wenn deine Website wesentliche Inhalte erst per JavaScript lädt, muss das Werkzeug Seiten auch rendern können. Rendering bedeutet hier, dass es Skripte ausführt und die anschließend sichtbare Seite untersucht, statt nur die erste HTML-Antwort zu lesen.
Soll Google eine einzelne URL erneut crawlen?
Hast du eine konkrete Seite geändert und möchtest Google auf diese URL aufmerksam machen, ist ein vollständiger eigener Website-Crawl dafür nicht der richtige Vorgang. Prüfe die betreffende URL im URL-Prüftool der Google Search Console und nutze dort die Möglichkeit, einen erneuten Crawl anzufordern. Die Anfrage ersetzt weder deinen technischen Check noch garantiert sie eine Aufnahme in den Index.
Dein Crawl zeigt, was das gewählte Werkzeug sieht. Die Search Console meldet dir Googles Informationen zu einer bestimmten URL. Halte diese beiden Perspektiven getrennt, auch wenn du nach einer Änderung beide brauchst.
Was solltest du vor dem Crawl festlegen?
Lege vor dem Start Ziel, Website-Bereich und benötigte Ausgabe fest. Sonst erhältst du möglicherweise viele URLs, ohne beurteilen zu können, ob die für deine Frage wichtigen Seiten überhaupt dabei sind.
Welche Domain und welcher Bereich gehören dazu?
Wähle die tatsächlich genutzte Website-Adresse als Startpunkt und entscheide, ob etwa ein Blog, ein Shop-Bereich oder die gesamte öffentlich erreichbare Website geprüft werden soll. Bei einem Shop können Filter- und Suchergebnisse den Lauf in Bereiche führen, die für deinen ersten Check keine Rolle spielen. Begrenze den Crawl entsprechend, sofern dein Werkzeug das erlaubt.
Prüfe auch, unter welchen Bedingungen der Crawler zugreift: Nutzt er denselben Host wie deine Besucher? Folgt er Weiterleitungen? Kommt er ohne Anmeldung an die gewünschten Seiten? Ein Crawl über öffentlich erreichbare Seiten kann keine Inhalte beurteilen, die nur nach einem Login erscheinen.
Die Datei robots.txt gehört ebenfalls zur Vorbereitung. Google beschreibt robots.txt als Möglichkeit, Suchmaschinen-Crawlern mitzuteilen, welche Seiten oder Dateien sie anfordern können und welche nicht. Öffne die Datei für deine Domain und prüfe Regeln für den betroffenen Bereich. Ob dein eigenes Werkzeug diese Regeln beachtet, musst du in dessen Einstellungen klären; sein Verhalten ist nicht automatisch mit dem des Google-Crawlers identisch.
Woran erkennst du ein passendes Werkzeug?
Wähle nach der benötigten Antwort, nicht nach der längsten Funktionsliste. Für einen kleinen Bereich reicht ein Werkzeug, dessen URL-Ausgabe du gut prüfen kannst. Bei JavaScript-Inhalten brauchst du eine nachvollziehbare Rendering-Option; bei vielen ähnlichen URLs sind Begrenzungen für Pfade und URL-Varianten hilfreich.
Achte vor dem Lauf darauf, ob du die erfassten URLs und Befunde exportieren oder zumindest einzeln öffnen kannst. Eine bloße Gesamtzahl hilft wenig, wenn du anschließend eine fehlerhafte Produktseite nicht wiederfindest.
Wie crawlst du deine Website Schritt für Schritt?
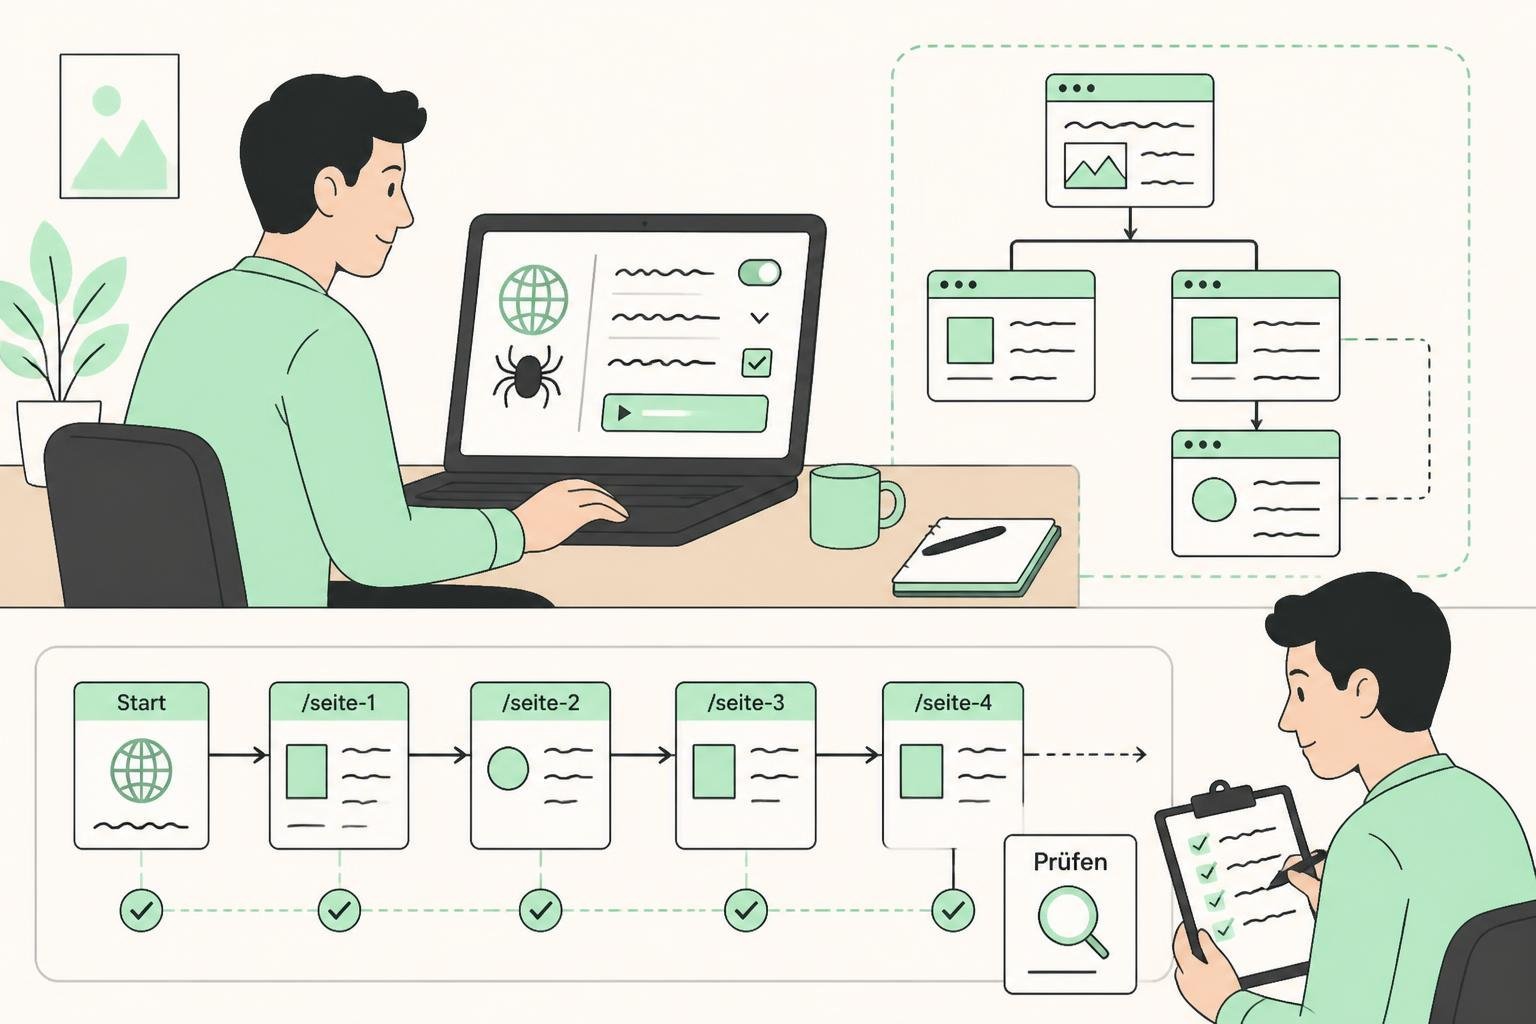
Beginne mit einem überschaubaren Bereich und kontrolliere die ersten Ergebnisse, bevor du den Umfang erhöhst. So merkst du früh, ob Startadresse, Zugriffsregeln und Rendering zu deiner Aufgabe passen.
- Gib die gewählte Start-URL ein und begrenze den Crawl auf den vorgesehenen Host oder Pfad. Stelle bei Bedarf ein, ob JavaScript ausgeführt werden soll.
- Starte den Lauf und öffne einige der zuerst erfassten URLs. Prüfe, ob der Crawler die beabsichtigten Seiten erreicht oder etwa bei einer Weiterleitung auf einem anderen Host landet.
- Sieh dir nach Abschluss die URL-Liste an. Vergleiche sie mit bekannten wichtigen Seiten aus dem gewählten Bereich und notiere URLs, die fehlen oder unerwartet auftauchen.
- Wähle für auffällige Befunde konkrete URLs aus. Öffne diese selbst, bevor du aus einer Meldung eine Änderung ableitest.
Fehlt eine bekannte Seite in der Ausgabe, ist das zunächst eine Aussage über diesen Crawl. Der Crawler hat sie womöglich über seine Start-URL und die gefundenen Links nicht erreicht oder wegen einer Einstellung ausgelassen. Prüfe den Linkweg und die Crawl-Grenzen, statt die Seite sofort als für Suchmaschinen unsichtbar einzustufen.
Wie wertest du Statuscodes und gerenderte Inhalte aus?
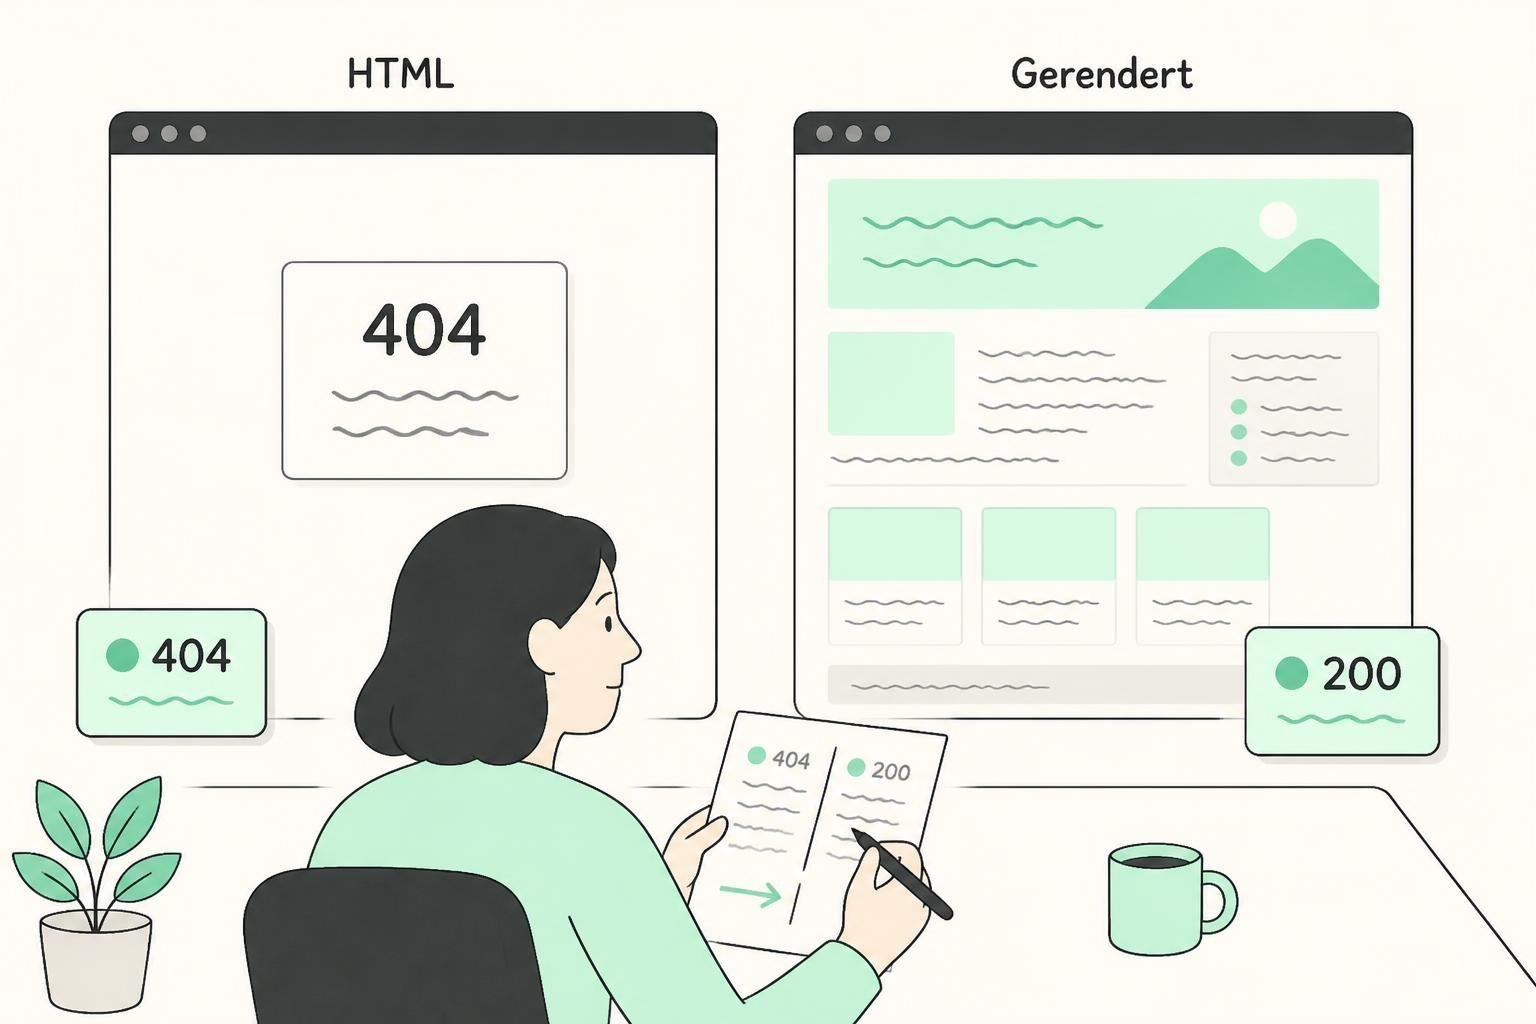
Sortiere die Ausgabe nach Befund und prüfe Beispiele an den betroffenen URLs. Ein Statuscode beschreibt die Antwort auf eine Anfrage; ob diese Antwort für die jeweilige Seite richtig ist, ergibt sich erst aus ihrem Zweck.
Bei einer wichtigen Inhaltsseite ist eine Fehlerantwort wie 404 ein Anlass, URL und interne Links zu prüfen. Eine Serverfehlerantwort wie 500 solltest du an der konkreten URL erneut untersuchen. Eine Weiterleitung kann gewollt sein, etwa nach einer Adressänderung; prüfe dann, ob sie zur gewünschten Zielseite führt. Nicht jede gemeldete URL braucht deshalb eine Korrektur.
Bei gerenderten Inhalten lohnt ein Vergleich zwischen der ersten HTML-Antwort und der Ansicht nach Ausführung von JavaScript. Fehlt beispielsweise ein wichtiger Beschreibungstext zunächst, erscheint aber in der gerenderten Ansicht, dokumentiere genau diesen Unterschied. Bleibt der Text auch dort aus, prüfe die Seite im Browser und die Einstellungen des Crawlers, bevor du einen Fehler am Inhalt annimmst.
Halte für jeden weiterzuverfolgenden Befund die URL, die Beobachtung und die offene Frage fest. Aus einer langen Fehlerliste werden so überprüfbare Fälle: „Warum liefert diese verlinkte Kategorieseite eine Fehlerantwort?“ ist nützlicher als „Shop prüfen“. Für die anschließende Bewertung mehrerer bestätigter Probleme gibt es einen eigenen Leitfaden, der Auditbefunde in einen Umsetzungsplan überführt.
Bedeutet ein erfolgreicher Crawl, dass Google die Seite indexiert hat?
Nein. Dein Crawler und Google stellen eigene Anfragen unter unterschiedlichen Bedingungen. Auch wenn dein Werkzeug eine Seite laden und ihren Inhalt lesen kann, belegt das weder einen Google-Crawl noch die Aufnahme der URL in den Google-Index.
Wenn der Indexierungsstatus einer bestimmten Seite für deine Entscheidung zählt, prüfe genau diese URL in der Google Search Console. Vergleiche den dort gemeldeten Status mit deinem technischen Befund, statt aus einer erfolgreichen Antwort des Website-Crawlers auf Indexierung zu schließen.
Wann ist ein Content-Crawl die passendere Aufgabe?
Ein technischer Crawl hilft dir bei erreichbaren URLs, Antworten und Darstellung. Geht es dagegen darum, vorhandene Themen zu verstehen und neue Inhalte vorzubereiten, brauchst du eine andere Auswertung der Website.
Geo-Autopilot crawlt die Website, um Markenstimme, Themen und Lücken zu erkennen. Die Plattform unterstützt anschließend Keyword-Recherche und erstellt Textentwürfe. Du entscheidest, welches Thema freigegeben wird, prüfst den Entwurf fachlich und verfeinerst ihn bei Bedarf. Einen auffälligen Statuscode oder eine robots.txt-Regel musst du weiterhin gezielt technisch untersuchen.
Wenn deine technischen Fragen geklärt sind und du vorhandene Themen für neue Inhalte auswerten willst, kannst du den Content-Workflow von Geo-Autopilot prüfen.
Wähle einen abgegrenzten Website-Bereich, notiere die Frage an den Crawl und teste an einigen bekannten URLs, ob die gewählte Ausgabe sie beantworten kann.