Eine pauschale Freigabe ist unnötig, wenn nur ein bestimmter KI-Crawler deine öffentlichen Seiten abrufen soll. Wenn du KI-Crawler erlauben möchtest, prüfe zuerst Betreiber und Zweck des Bots und formuliere dann eine passende Regel in der robots.txt. Die Datei signalisiert erwünschtes Crawling, schützt aber keine vertraulichen Inhalte. Geo-Autopilot, eine Plattform für SEO- und GEO-Textentwürfe, kann öffentliche Inhalte für deine Website vorbereiten; welchen Bots du Crawling signalisierst, entscheidest und konfigurierst du selbst.
Stand: November 2026
Was bedeutet es, einen KI-Crawler zu erlauben?
Eine Freigabe in der robots.txt richtet sich an Crawler, die diese Datei beachten. Du kannst Regeln einem bestimmten User-Agent zuordnen, also der Kennung, unter der sich ein Bot bei seiner Anfrage meldet. Damit beschreibst du, welche URL-Pfade dieser Bot nach deinem Wunsch abrufen darf und welche nicht.
Für öffentlich lesbare Seiten ist eine ausdrückliche Allow-Anweisung häufig gar nicht nötig: Fehlt eine passende Sperre, kann ein Bot, der sich an robots.txt hält, diese Seiten grundsätzlich crawlen. Prüfe deshalb die bestehende Datei, bevor du eine zusätzliche Regel einfügst. Vielleicht gibt es bereits eine pauschale Sperre, von der du einen ausgewählten Bot ausnehmen willst.
Eine robots.txt-Regel ist keine Anmeldung und keine Zugriffssperre. ComputerWeekly erläutert die fehlende technische Durchsetzung und Zweckkontrolle des Protokolls: Die Datei kann einem Crawler keine verbindlichen Vorgaben dazu machen, wie er abgerufene Inhalte später verwendet.
Welche KI-Crawler solltest du freigeben?
Wähle Bots nach Betreiber und Zweck aus, nicht nach einer möglichst langen Liste von User-Agents. Für einen öffentlichen Ratgeber kann Crawling erwünscht sein; Kundenkonten, interne Dokumente und noch unveröffentlichte Inhalte brauchen dagegen eigenen Zugriffsschutz. Der Name eines Anbieters allein verrät noch nicht, welchem Zweck jeder seiner Crawler dient.
Wie prüfst du Betreiber und User-Agent?
Suche für den konkreten Bot nach der aktuellen Dokumentation seines Betreibers. Gleiche den dort genannten User-Agent mit der Kennung ab, die du in die robots.txt schreiben willst, und prüfe, ob der Betreiber weitere Kennungen für andere Abrufe nennt. Eine Regel für GPTBot betrifft nur Anfragen, auf die diese Kennung nach den geltenden robots.txt-Regeln passt; sie ist keine Freigabe für sämtliche Bots desselben Anbieters.
Ein Eintrag im Zugriffsprotokoll mit dem Namen eines bekannten Bots beweist dessen Identität nicht. User-Agents lassen sich nachahmen. Wenn du Zugriffe untersuchst, nutze zusätzlich die vom Betreiber veröffentlichten Angaben zur Identifizierung und lass auffällige Anfragen technisch prüfen. Cloudflares Übersicht zu AI Crawl Control bietet eine ergänzende Perspektive auf crawlerbezogene Kontrollen.
Warum musst du zwischen verschiedenen Zwecken unterscheiden?
Ein Anbieter kann Inhalte für unterschiedliche Anwendungen abrufen wollen, etwa für die Aufbereitung von Suchantworten oder für das Training von Modellen. Wenn diese Unterscheidung für dich zählt, prüfe die jeweils dokumentierte Kennung und den angekündigten Zweck, bevor du eine Regel setzt. Unterstelle nicht, dass eine Freigabe für einen Bot automatisch nur einen bestimmten Nutzungszweck gestattet.
Fehlt eine klare Zuordnung, lass die Entscheidung offen und kläre sie anhand der Betreiberangaben. Eine vorsorgliche Freigabe aller KI-Bots löst diese Unsicherheit nicht.
Wie erlaubst du einen bestimmten Crawler in der robots.txt?
Du brauchst Zugriff auf die tatsächlich ausgelieferte Datei unter /robots.txt deiner Domain und musst wissen, welche bestehenden Regeln bereits gelten. Sichere die aktuelle Fassung und notiere die öffentlichen Seiten, die der ausgewählte Bot abrufen können soll. Halte auch fest, welche Pfade ausgeschlossen bleiben sollen.
Wie sieht eine Regel für GPTBot aus?
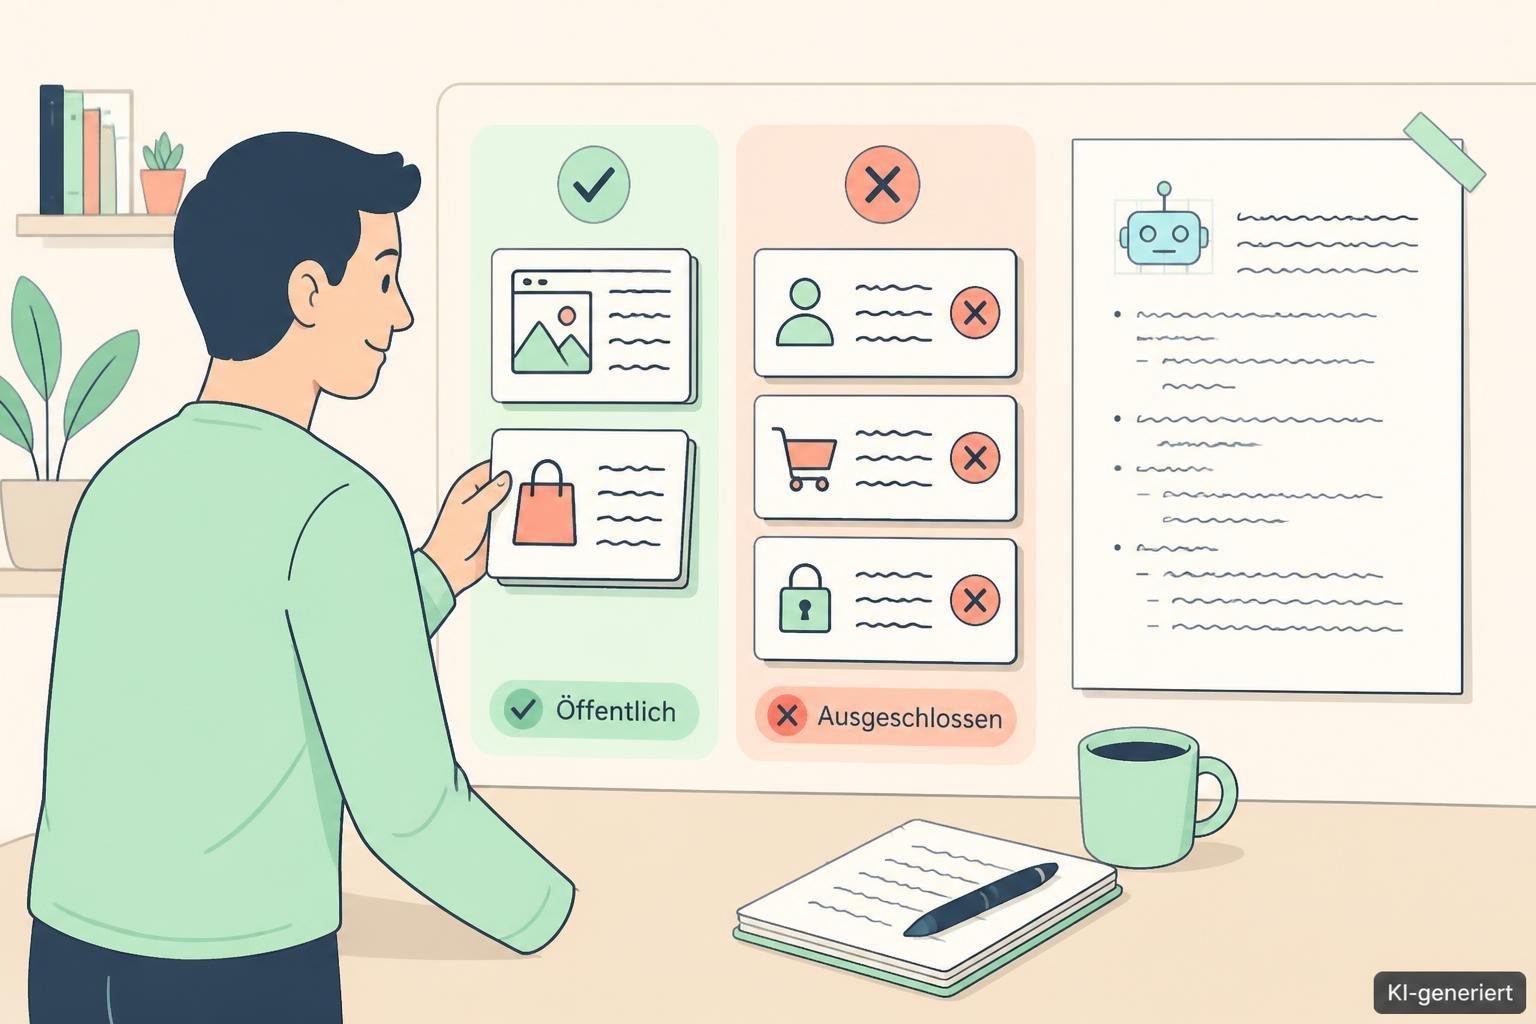
Das folgende Beispiel richtet eine eigene Gruppe für den User-Agent GPTBot ein. Die genannten Pfade stehen exemplarisch für Bereiche, die der Bot nach der Regel nicht crawlen soll; alle anderen Pfade bleiben in diesem Beispiel ohne Sperre durch diese Gruppe.
User-agent: GPTBot
Disallow: /intern/
Disallow: /konto/
Disallow: /checkout/
Setze nur Pfade ein, die zu deiner Website passen. Bei einem Shop können etwa Warenkorb und Kundenkonto relevant sein, während eine öffentlich lesbare Produktkategorie erreichbar bleiben soll. Prüfe Schreibweise und Pfade an echten URLs deiner Website. Eine Regel für /konto/ sagt beispielsweise nichts über eine anders benannte Login-URL aus.
Besteht bereits eine Gruppe User-agent: * mit Disallow: /, prüfe die Regeln besonders sorgfältig: Eine eigene Gruppe für GPTBot kann diesem Bot andere Pfade zugänglich signalisieren als die allgemeine Gruppe. Ergänze in der eigenen Gruppe dann alle Einschränkungen, die für ihn weiterhin gelten sollen. Andere ausdrücklich benannte Bot-Gruppen und Einstellungen außerhalb der robots.txt musst du getrennt betrachten.
Wie begrenzt du die Freigabe auf gewünschte URLs?
Eine eigene Bot-Gruppe mit wenigen Disallow-Pfaden ist sinnvoll, wenn der Großteil deiner Website öffentlich gecrawlt werden darf. Soll dagegen nur ein kleiner Bereich freigegeben werden, plane die erlaubten und ausgeschlossenen Pfade anhand der vorhandenen Regeln und teste die Kombination vor der Veröffentlichung. Ein einzelnes Allow: /ratgeber/ beschreibt ohne passende Sperre für andere Pfade keine Freigabe, die auf den Ratgeber begrenzt wäre.
Denk dabei an deine tatsächliche URL-Struktur: Inhalte können unter mehreren Pfaden liegen, und CMS, Shop oder Hosting können die robots.txt selbst erzeugen. Bearbeite deshalb die Stelle, aus der die öffentlich erreichbare Datei stammt, statt eine zweite Datei ohne Wirkung abzulegen. Nach der Änderung muss die ausgelieferte Fassung deine beabsichtigten Regeln enthalten.
Wie prüfst du die Änderung vor und nach der Veröffentlichung?
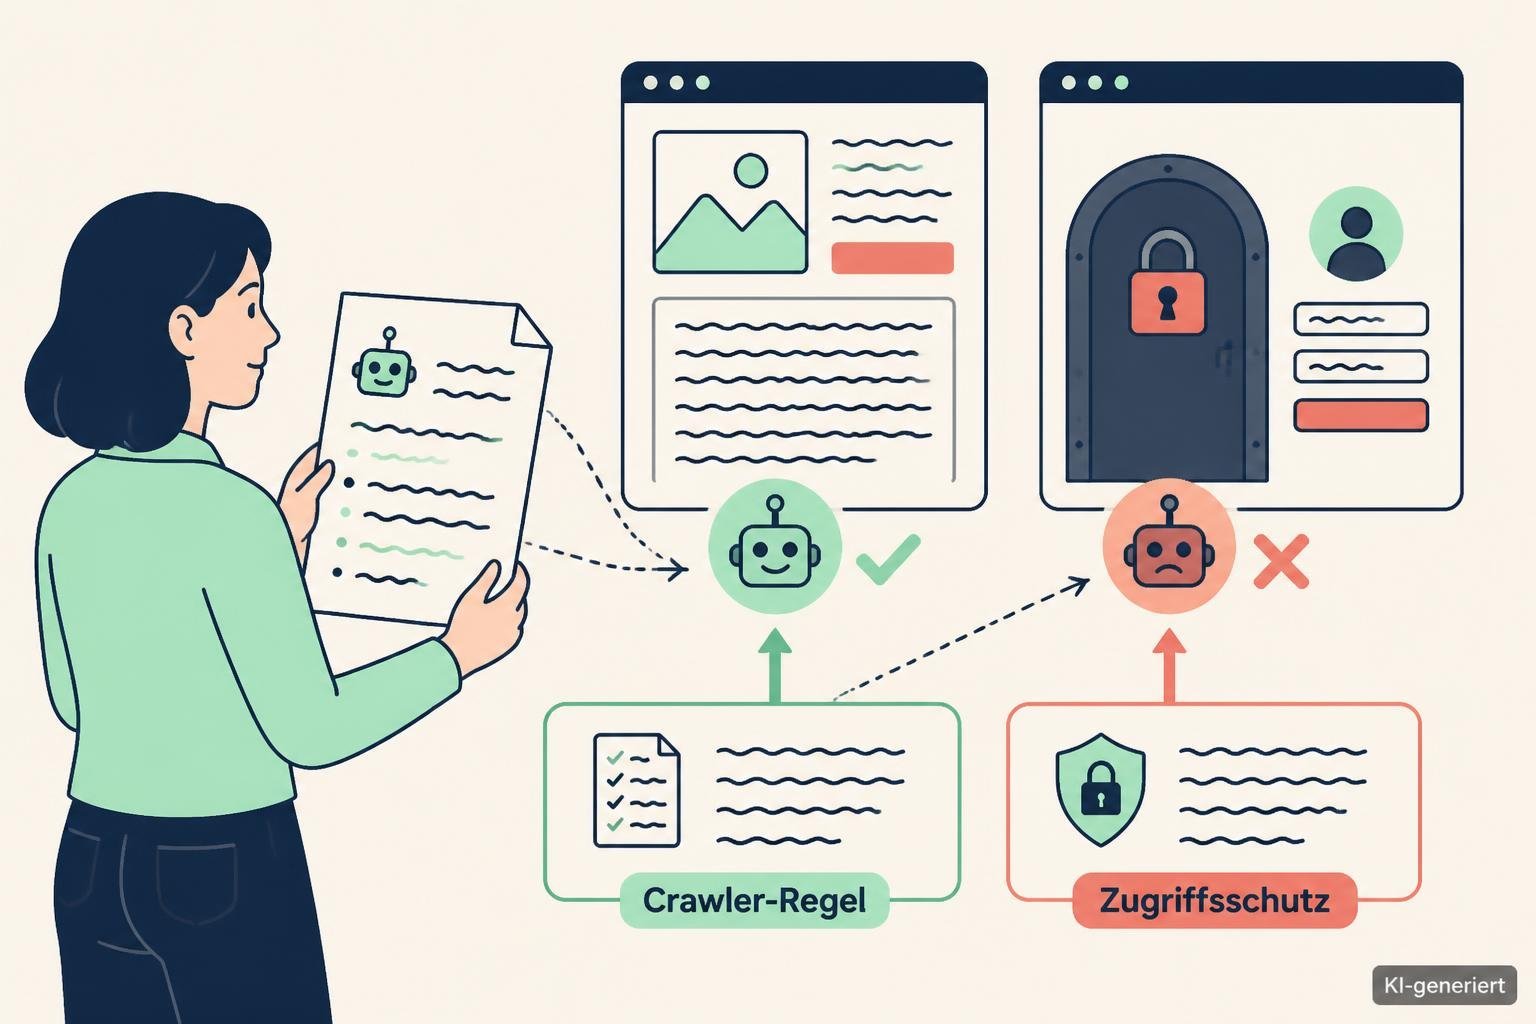
Vergleiche zuerst die alte und die neue robots.txt. Für den ausgewählten User-Agent solltest du erklären können, welche Beispiel-URL nun abrufbar signalisiert wird und welche weiterhin ausgeschlossen ist. Wenn dein CMS oder ein Prüfwerkzeug einen robots.txt-Test für einzelne URLs anbietet, teste beide Fälle mit genau diesem User-Agent.
Öffne anschließend die öffentliche Datei im Browser und kontrolliere die ausgegebenen Regeln. Prüfe außerdem, ob eine freigegebene Seite ohne Anmeldung erreichbar ist und ob ein sensibler Bereich wirklich eigenen Zugriffsschutz hat. Für vertrauliche Inhalte brauchst du technische Maßnahmen wie Authentifizierung oder Zugriffsbeschränkungen auf Serverebene; ein Disallow-Eintrag reicht dafür nicht.
Zugriffsprotokolle können später zeigen, ob Anfragen mit der betreffenden Bot-Kennung eintreffen. Sie belegen für sich genommen weder die Identität des Bots noch, dass jede freigegebene URL abgerufen wurde. Halte deshalb getrennt fest, was du konfiguriert hast und was du tatsächlich beobachtest.
Garantiert die Freigabe Indexierung oder KI-Zitate?
Eine robots.txt-Freigabe beseitigt lediglich ein mögliches Hindernis für das Crawling durch einen Bot, der die Regeln beachtet. Der Betreiber entscheidet weiterhin, ob und wann er Seiten abruft und wie er die Inhalte verarbeitet. Aus einer erlaubten Anfrage folgt keine Aufnahme in einen Suchindex.
Eine Zitierung in ChatGPT oder einer anderen KI-Antwort lässt sich mit der Freigabe ebenfalls nicht zusichern. Solche Antworten hängen vom jeweiligen Dienst und der konkreten Anfrage ab. Halte deshalb drei Befunde auseinander: Der Bot darf nach deiner Regel crawlen, ein Abruf ist tatsächlich zu sehen und deine Seite erscheint gegebenenfalls als Quelle. Nur den ersten Befund steuerst du mit der robots.txt.
Wenn die technische Freigabe geklärt ist und du öffentliche Seiten für passende Suchfragen vorbereiten willst, sieh dir den Content-Workflow von Geo-Autopilot an. Themenauswahl, fachliche Prüfung und Bot-Regeln bleiben bei dir.
Nimm jetzt einen gewünschten Bot und zwei konkrete URLs deiner Website: eine öffentliche Seite und einen sensiblen Bereich. Prüfe Betreiber und Zweck, lies die ausgelieferte robots.txt und teste, ob ihre Regeln für beide URLs genau deiner Entscheidung entsprechen.